Lorsque nous ouvrons un dossier contenant de la musique, un fichier MP3 paraît extrêmement simple.
Une icône.
Un nom.
Une extension .mp3.
Une taille de quelques mégaoctets.
Pourtant, derrière cette apparente simplicité se trouve une organisation technique particulièrement intéressante.
Un fichier MP3 contient essentiellement un flux audio compressé organisé en une succession de trames.
On parle également de frames MP3.
Ces trames constituent l’une des structures fondamentales du format.
Plutôt que de stocker toute la musique dans un seul bloc indivisible, le flux MP3 est découpé en petites unités successives.
Le lecteur peut ainsi avancer progressivement dans le fichier.
Il trouve une trame, analyse ses informations, récupère les données audio correspondantes, les décode puis passe à la suivante.
Cette succession continue permet finalement de reconstruire toute la musique.
On peut imaginer le fichier de manière simplifiée :
Métadonnées éventuelles.
Trame MP3 numéro 1.
Trame MP3 numéro 2.
Trame MP3 numéro 3.
Trame MP3 numéro 4.
Et ainsi de suite jusqu’à la fin du flux audio.
Chaque trame contient plusieurs éléments.
L’un des plus importants est son header.
Le header, ou en-tête, fournit au décodeur des informations nécessaires pour interpréter correctement la trame.
Dans le cas d’un flux MPEG Audio Layer III, cet en-tête contient notamment des informations permettant d’identifier la version MPEG, la couche utilisée, le bitrate, la fréquence d’échantillonnage et le mode des canaux audio.
Le lecteur n’a donc pas besoin de deviner comment interpréter les données.
Une partie des instructions nécessaires se trouve directement dans le flux.
Le début d’un header MP3 possède notamment une séquence de synchronisation.
Cette information aide le décodeur à localiser le début d’une trame.
Elle est souvent appelée frame sync.
La synchronisation est particulièrement importante.
Si un lecteur commence à analyser des données au mauvais endroit, il doit pouvoir retrouver une position correspondant au début d’une trame valide.
Une fois cette synchronisation trouvée, il peut examiner les autres informations du header.
La version MPEG est notamment indiquée.
Lorsque l’on parle couramment du MP3 à 320 kb/s, on rencontre fréquemment MPEG-1 Audio Layer III.
Mais le Layer III existe également dans le cadre de MPEG-2 et MPEG-2.5, avec notamment des fréquences d’échantillonnage et des débits différents.
Le header indique également la couche audio.
Dans MP3, le chiffre 3 ne signifie d’ailleurs pas « MPEG version 3 ».
MP3 correspond à MPEG Audio Layer III.
Il s’agit donc de la troisième couche audio de cette famille de technologies.
Une autre information importante du header concerne le bitrate.
Selon le type de flux, le lecteur peut déterminer le débit associé à la trame grâce aux informations présentes dans l’en-tête.
Dans un fichier CBR, ou Constant Bit Rate, le bitrate reste constant au cours du flux.
Dans un fichier VBR, ou Variable Bit Rate, différentes trames peuvent utiliser des débits différents.
Cette variation permet d’adapter la quantité de données à la complexité du signal.
Le header contient également des informations concernant la fréquence d’échantillonnage.
On peut par exemple rencontrer 44,1 kHz ou 48 kHz dans des fichiers MPEG-1 Layer III.
Cette information est essentielle pour reconstruire correctement le signal audio dans le temps.
Le mode des canaux est également indiqué.
Le flux peut notamment être mono, stéréo, dual channel ou joint stereo.
Le joint stereo mérite une attention particulière.
Lorsque les canaux gauche et droit possèdent des informations communes, certaines techniques peuvent exploiter cette similarité afin d’utiliser plus efficacement les données disponibles.
L’objectif reste toujours le même :
obtenir le meilleur résultat possible avec le nombre de bits disponible.
Mais le header ne représente qu’une petite partie de la trame.
Après les informations d’en-tête viennent les données nécessaires au décodage du signal audio.
Pour MPEG-1 Layer III, on rencontre notamment une structure appelée side information.
Elle contient différentes informations utilisées par le décodeur pour reconstruire les données audio.
Viennent ensuite les données audio compressées elles-mêmes.
Celles-ci résultent des opérations que nous avons découvertes dans les articles précédents :
analyse du signal,
traitement fréquentiel,
modèle psychoacoustique,
allocation des bits,
quantification,
et codage.
Le décodeur effectue ensuite les opérations nécessaires pour reconstruire des échantillons audio à partir de ces informations.
Une particularité technique du MP3 est également appelée bit reservoir.
Le principe permet à certaines trames de ne pas être totalement indépendantes au niveau de l’utilisation des données.
Lorsqu’une partie du signal nécessite relativement peu de bits, une partie de la capacité disponible peut contribuer à aider des portions plus complexes.
Cette technique améliore l’efficacité de la compression.
Elle signifie cependant qu’une trame MP3 ne doit pas toujours être imaginée comme une petite boîte totalement isolée contenant absolument toutes les données dont elle a besoin.
Le flux possède une organisation plus subtile.
La taille d’une trame dépend notamment du bitrate et de la fréquence d’échantillonnage.
Pour MPEG-1 Layer III, une trame représente généralement 1 152 échantillons audio par canal.
À une fréquence d’échantillonnage de 44 100 Hz, cela correspond à environ 26 millisecondes de musique.
Une chanson de plusieurs minutes contient donc des milliers de trames successives.
Prenons une musique de quatre minutes.
Quatre minutes correspondent à 240 secondes.
Si chaque trame représente environ 0,026 seconde, le fichier peut contenir de l’ordre de plusieurs milliers de trames.
Le lecteur les traite suffisamment rapidement pour que nous percevions un flux musical continu.
Cette organisation explique également pourquoi il est possible de diffuser du MP3 sous forme de flux.
Le décodeur peut commencer à travailler sur les données reçues sans nécessairement disposer de toute la chanson.
Il lui faut principalement disposer d’un flux suffisant et correctement organisé.
C’est l’un des éléments qui ont rendu le MP3 particulièrement intéressant pour Internet.
Mais où se trouvent le titre, l’artiste ou la pochette ?
Ces informations ne font pas partie de la musique compressée elle-même.
Elles sont généralement stockées dans des métadonnées.
Le système le plus connu pour le MP3 est ID3.
Un tag ID3 peut contenir de nombreuses informations :
le titre,
l’artiste,
l’album,
l’année,
le genre,
le numéro de piste,
des commentaires,
et même une image de pochette.
Avec ID3v2, les métadonnées sont généralement placées au début du fichier.
Le lecteur peut donc les récupérer rapidement avant même de commencer réellement la lecture du flux audio.
Des métadonnées peuvent également exister à d’autres endroits selon les versions et les systèmes employés.
L’ancien ID3v1 utilisait notamment une petite structure située à la fin du fichier.
Cette séparation entre audio et métadonnées est importante.
Modifier le titre d’une musique dans les tags ID3 ne nécessite normalement pas de réencoder tout le signal audio.
On modifie les informations descriptives du fichier, pas la musique compressée elle-même.
Cela permet également d’intégrer une pochette dans un fichier MP3.
L’image est stockée dans les métadonnées.
Elle peut donc augmenter la taille totale du fichier sans modifier le bitrate du flux audio.
Un MP3 contenant une pochette JPEG de 1 Mo sera logiquement plus volumineux qu’un fichier utilisant exactement le même flux audio mais une pochette de seulement quelques dizaines de kilo-octets.
C’est pourquoi deux MP3 ayant la même durée et le même bitrate peuvent présenter une légère différence de taille.
Les métadonnées peuvent en être l’une des raisons.
Les fichiers VBR peuvent également contenir des informations complémentaires destinées à faciliter la navigation et l’identification du débit variable.
On rencontre notamment des en-têtes ou structures associés à des technologies comme Xing ou VBRI.
Ils peuvent fournir au lecteur des informations utiles concernant la durée, le nombre de trames ou la navigation dans le fichier.
Lorsque nous observons un MP3 dans un éditeur hexadécimal, nous ne voyons donc pas simplement « de la musique ».
Nous voyons une succession organisée d’octets ayant chacun un rôle dans la structure générale du fichier.
On peut résumer très simplement un MP3 ainsi :
des métadonnées pour décrire la musique,
des headers pour décrire les caractéristiques du flux,
des informations techniques nécessaires au décodage,
et des données audio compressées réparties dans une succession de trames.
Le lecteur MP3 parcourt cette structure à grande vitesse.
Il trouve les trames.
Il interprète leurs headers.
Il récupère les informations nécessaires.
Il décode les données audio.
Il reconstruit progressivement les échantillons numériques.
Pour l’utilisateur, tout cela se résume pourtant à une seule action :
appuyer sur Lecture.
Cette architecture relativement compacte a contribué à rendre le MP3 extrêmement polyvalent.
Un même fichier peut être copié, téléchargé, envoyé, diffusé ou lu par une multitude d’appareils différents.
Tant que le lecteur comprend le standard MP3, il sait comment interpréter le flux.
Nous savons maintenant ce qui se cache à l’intérieur du fichier.
Mais une partie mérite un article complet.
Titre, artiste, album, numéro de piste, année, genre et pochette peuvent accompagner directement la musique grâce aux tags ID3.
Dans le prochain article, nous allons donc découvrir comment fonctionnent les métadonnées ID3 et comment elles transforment un simple fichier audio en élément organisé d’une bibliothèque musicale.
Articles relatifs à la catégorie
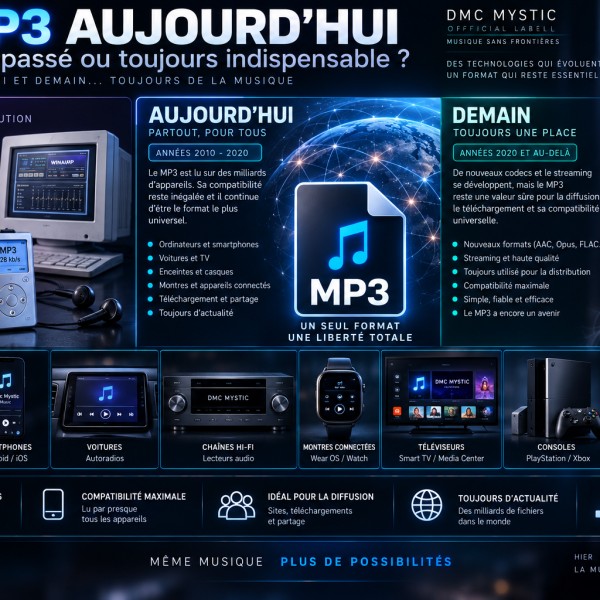
Le MP3 existe depuis plusieurs décennies, alors que le stockage, Internet et les technologies audio ont énormément évolué. Des codecs plus récents et des formats sans pertes sont désormais largement disponibles. Pourtant, le MP3 continue d’être lu par des ordinateurs, smartphones, autoradios, chaînes Hi-Fi, téléviseurs et de nombreux appareils. Pourquoi ce format historique reste-t-il encore aussi présent ?
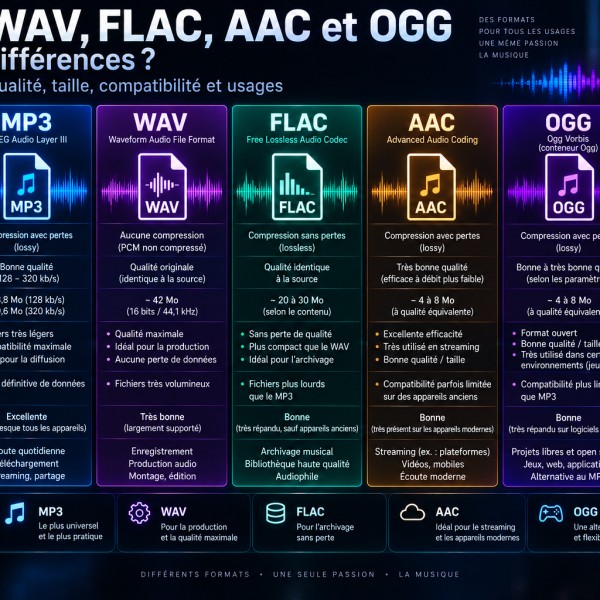
MP3, WAV, FLAC, AAC ou OGG : derrière ces extensions se trouvent différentes manières de stocker et de compresser la musique. Certains formats privilégient la qualité originale, d’autres la réduction de taille ou la compatibilité. Comprendre leurs différences permet de choisir le format adapté à l’écoute, au téléchargement, à l’archivage ou à la production musicale.
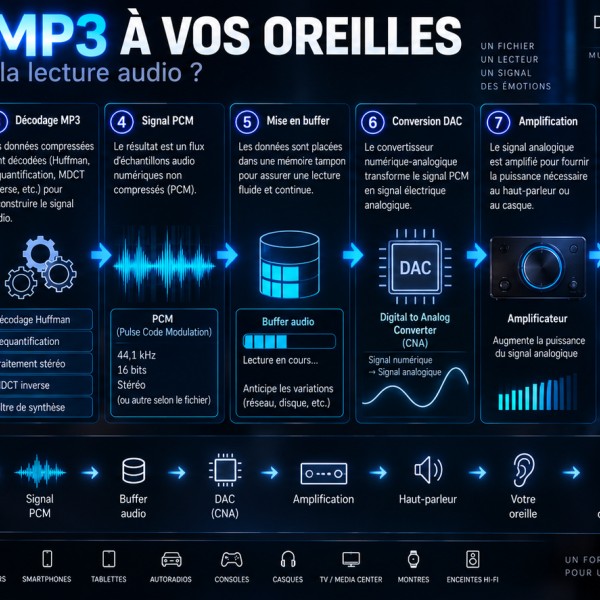
Appuyer sur Lecture semble instantané, mais une véritable chaîne de traitement se met alors en fonctionnement. Le lecteur doit analyser les trames MP3, décoder les données compressées, reconstruire le signal numérique PCM puis le convertir en signal analogique avant que les haut-parleurs ou le casque puissent produire du son. Découvrons ce voyage du fichier jusqu’à nos oreilles.
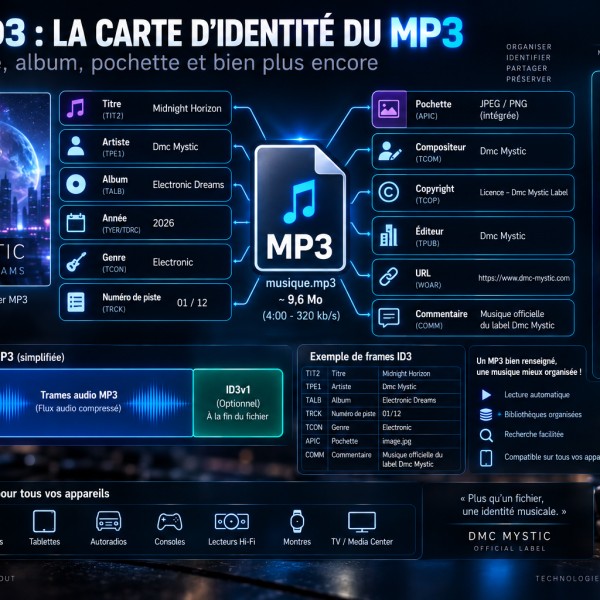
Un fichier MP3 peut contenir bien plus que de la musique. Titre, artiste, album, année, genre, numéro de piste, commentaires et même pochette peuvent être enregistrés directement dans le fichier grâce aux tags ID3. Ces métadonnées permettent aux lecteurs et aux bibliothèques musicales d’identifier et d’organiser automatiquement chaque morceau.
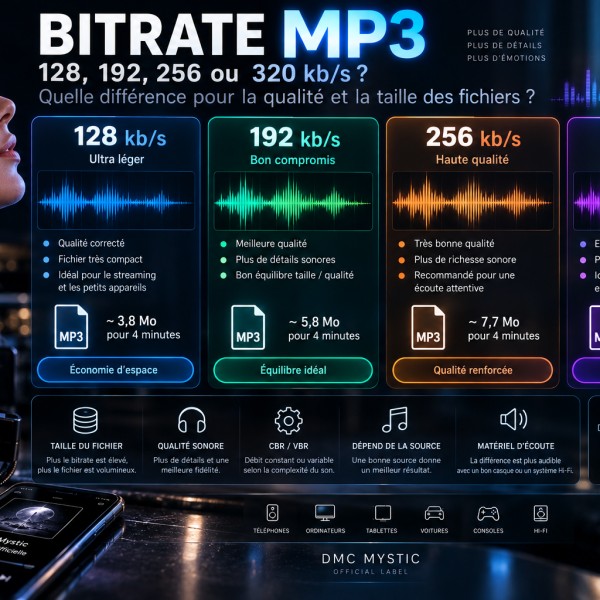
128, 192, 256 ou 320 kb/s : ces valeurs apparaissent régulièrement lorsqu’on parle de fichiers MP3. Elles correspondent au bitrate, c’est-à-dire à la quantité de données utilisée chaque seconde pour représenter la musique. Plus le débit est important, plus l’encodeur dispose de données, mais plus le fichier devient volumineux. Voyons ce que ces valeurs changent réellement.
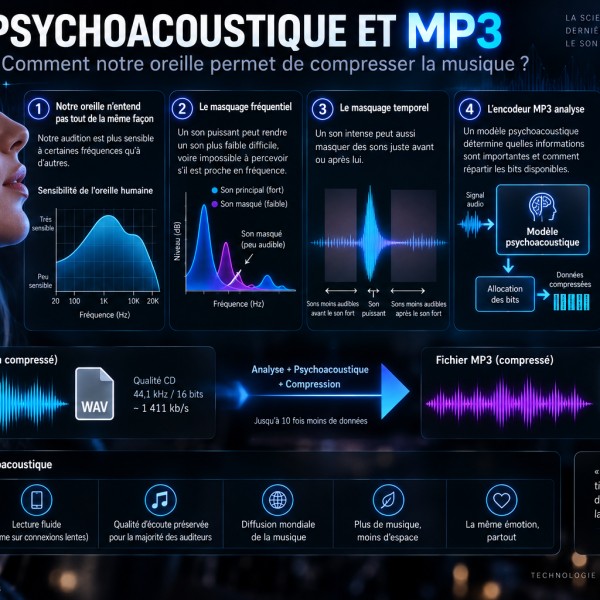
La compression MP3 ne repose pas uniquement sur des mathématiques. Elle exploite également certaines caractéristiques de notre système auditif. Grâce à la psychoacoustique et aux phénomènes de masquage sonore, l’encodeur peut déterminer quelles informations sont essentielles à notre perception et lesquelles peuvent être représentées avec moins de précision. Découvrons comment notre propre audition participe indirectement à la compression d’un fichier MP3.
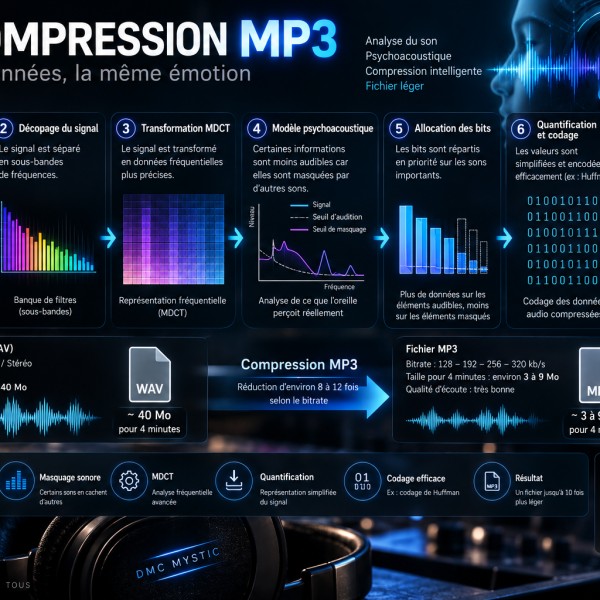
La compression MP3 permet de transformer un fichier audio volumineux en un fichier beaucoup plus léger. Pour y parvenir, l’encodeur analyse le signal sonore, exploite certaines caractéristiques de l’audition humaine et réduit la quantité de données nécessaires à sa représentation. Découvrons comment fonctionne réellement cette compression.
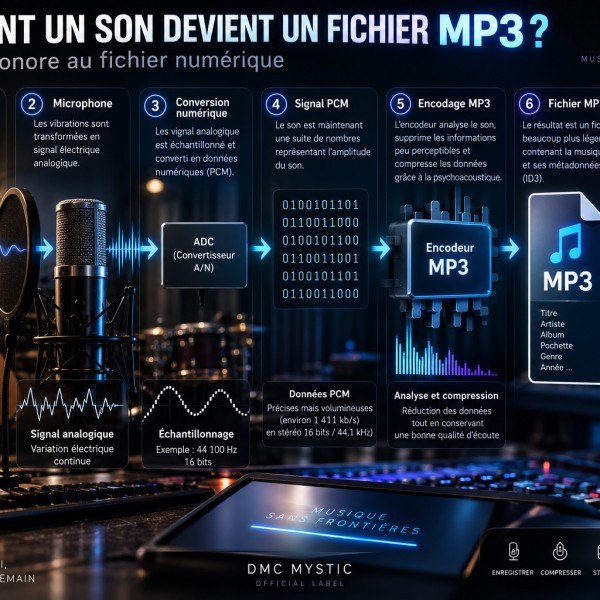
Une voix, une guitare ou une batterie produisent d’abord des vibrations dans l’air. Pour enregistrer ces sons dans un fichier MP3, il faut les transformer en données numériques que l’ordinateur peut analyser, compresser, stocker et reproduire. Découvrons étape par étape comment une onde sonore devient finalement un fichier MP3.
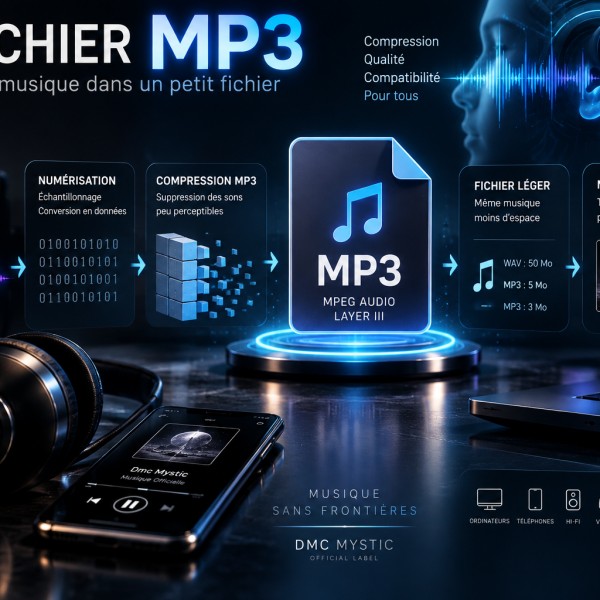
Le MP3 est l’un des formats audio numériques les plus connus au monde. Derrière cette simple extension se cache pourtant une technologie de compression capable de réduire fortement la taille d’un fichier audio tout en conservant une qualité d’écoute satisfaisante. Dans cet article, nous allons découvrir ce qu’est réellement un fichier MP3, comment il est organisé et pourquoi ce format a profondément changé notre manière d’écouter et de distribuer de la musique.