Un fichier audio ne connaît pas forcément son propre titre
Imaginons un fichier appelé :
01-house-color.mp3
Pour une personne, ce nom fournit déjà quelques informations.
Un logiciel de lecture ne peut cependant pas deviner avec certitude que le morceau s’appelle « House Color », qu’il appartient à un album particulier, qu’il a été créé en 2026 ou qu’il relève de la House.
Le nom du fichier et les informations musicales qu’il contient sont deux choses différentes.
C’est précisément là qu’interviennent les métadonnées.
Les métadonnées accompagnent la musique
Les métadonnées sont des informations associées au contenu principal.
Dans le cas d’un fichier musical, le contenu principal est évidemment le son.
Les métadonnées décrivent ce son.
Elles peuvent notamment indiquer le titre du morceau, l’artiste, l’album, l’année, le genre musical ou encore son numéro dans la liste des pistes.
Ces informations peuvent être lues par de nombreux logiciels sans devoir analyser le nom du fichier ou connaître l’organisation du serveur sur lequel il était initialement stocké.
Le morceau devient donc beaucoup plus autonome.
Qu’est-ce qu’un tag ID3 ?
ID3 désigne une famille de métadonnées largement associée aux fichiers MP3.
Ces informations sont intégrées au fichier ou associées à sa structure de manière à pouvoir être interprétées par les logiciels compatibles.
Lorsqu’un lecteur affiche automatiquement le titre d’un morceau, le nom de l’artiste et la pochette, il utilise généralement les métadonnées disponibles.
L’utilisateur ne voit donc pas nécessairement les tags.
Il voit leur résultat.
Le titre est l’information la plus évidente
Le titre du morceau constitue naturellement l’un des champs les plus importants.
Il permet au lecteur d’afficher :
House Color
plutôt qu’un nom technique tel que :
01-house-color-final-master-v3.mp3
Cette distinction est importante.
Le nom du fichier peut répondre à des contraintes techniques d’organisation.
Le titre affiché au public doit rester propre et lisible.
Les métadonnées permettent de séparer ces deux besoins.
L’artiste identifie l’origine du morceau
Le champ artiste permet de rattacher une piste à son créateur ou interprète.
Cette information devient essentielle lorsque plusieurs artistes coexistent dans la même bibliothèque.
Même dans un catalogue consacré principalement à un seul artiste, il reste utile de renseigner correctement ce champ.
Le fichier peut être téléchargé, copié ou lu ailleurs.
Son identité doit pouvoir voyager avec lui.
L’album rassemble plusieurs pistes
Le champ album permet de conserver le lien entre plusieurs morceaux appartenant au même projet.
Sans cette information, un lecteur peut parfaitement afficher toutes les pistes comme des éléments indépendants.
Avec elle, il peut les regrouper.
Cette logique rejoint directement celle d’un catalogue Web.
Un album possède une identité.
Les pistes possèdent leur propre identité.
Mais chaque piste doit également savoir à quel album elle appartient.
Le numéro de piste conserve l’ordre
Les noms de fichiers commencent souvent par :
01
02
03
Cette méthode est pratique dans un répertoire.
Mais l’ordre d’un album peut également être enregistré dans les métadonnées.
Le lecteur dispose alors d’une information explicite indiquant la position du morceau.
Cette donnée devient particulièrement importante lorsque les fichiers sont copiés dans un environnement qui ne conserve pas nécessairement leur classement original.
L’ordre artistique de l’album reste ainsi attaché aux morceaux.
L’année situe la publication
L’année peut sembler être une information secondaire.
Dans un catalogue important, elle devient pourtant très utile.
Elle permet de suivre l’évolution d’un artiste, de classer plusieurs périodes de production et de retrouver rapidement les projets d’une époque particulière.
Elle apporte également du contexte.
Deux albums séparés par plusieurs années peuvent utiliser des outils, des méthodes ou des influences très différentes.
La date participe donc à l’histoire du catalogue.
Le genre facilite la classification
House, Techno, Acid, Ambient, Electro, Rock électronique…
Le genre constitue un repère.
Il ne décrit jamais parfaitement toute la richesse d’un morceau, mais il permet de construire une première classification.
Cette information devient particulièrement intéressante lorsqu’elle est utilisée de manière cohérente entre la base de données du site et les fichiers audio.
Un album identifié comme House dans le catalogue ne devrait idéalement pas voir ses pistes classées arbitrairement dans un autre genre sans raison particulière.
La cohérence des métadonnées évite progressivement la création de plusieurs vérités contradictoires.
La pochette peut accompagner le fichier
Les métadonnées musicales peuvent également permettre d’associer une image au morceau.
C’est pourquoi certains lecteurs affichent automatiquement la pochette lorsqu’un MP3 est lancé.
Cette fonction est particulièrement utile lorsque le fichier quitte son site d’origine.
Même téléchargé et lu localement, il peut conserver une partie de l’identité visuelle de son album.
Le son et l’image restent ainsi liés.
Des informations supplémentaires peuvent compléter l’identité
Selon le format et les besoins du catalogue, d’autres informations peuvent être enregistrées.
Compositeur.
Éditeur.
Copyright.
Commentaire.
Sous-titre.
Informations techniques.
Chaque catalogue n’a pas besoin d’utiliser tous les champs disponibles.
L’essentiel consiste à définir une structure cohérente et à la respecter.
Mieux vaut quelques informations correctement renseignées sur toutes les pistes qu’une multitude de champs utilisés différemment d’un album à l’autre.
Métadonnées et base SQL ne jouent pas exactement le même rôle
Dans un site musical moderne, les informations peuvent exister à plusieurs endroits.
La base SQL peut connaître le titre de l’album, son année, son genre et toutes ses pistes.
Le fichier MP3 peut contenir une partie de ces informations dans ses tags.
Le site peut également posséder des fichiers JSON destinés au cache, aux lecteurs ou à différentes interfaces.
Ces systèmes ne sont pas nécessairement concurrents.
Ils peuvent travailler ensemble.
La base SQL constitue une source structurée pour le site.
Les caches accélèrent ou simplifient certains usages.
Les tags permettent au fichier audio de conserver son identité lorsqu’il est utilisé indépendamment.
Le véritable danger : les informations contradictoires
Les problèmes apparaissent lorsque plusieurs sources contiennent des valeurs différentes.
Un album peut par exemple être enregistré comme :
Genre : House
dans la base SQL, mais comme :
Genre : Electro
dans un ancien fichier JSON.
Un fichier MP3 peut encore contenir une troisième valeur.
À petite échelle, cette différence semble sans importance.
Sur plusieurs centaines ou milliers de pistes, elle devient difficile à gérer.
Il faut donc déterminer quelle source fait autorité et organiser les migrations autour de cette décision.
Pourquoi automatiser les métadonnées ?
Modifier manuellement les tags de quelques morceaux reste possible.
Modifier plusieurs centaines de fichiers devient rapidement fastidieux.
L’automatisation permet d’utiliser les informations déjà présentes dans le catalogue.
Si la base connaît l’artiste, l’album, l’année, le genre et le numéro de piste, un outil peut préparer automatiquement une grande partie des métadonnées.
L’intervention humaine se concentre alors sur la validation et les cas particuliers.
Cette approche réduit également les erreurs de frappe et les variations inutiles.
Les métadonnées facilitent les migrations
Lorsqu’un catalogue change de serveur ou de système de stockage, les fichiers correctement identifiés sont beaucoup plus faciles à retrouver.
Le nom d’un répertoire peut changer.
Une URL peut être réécrite.
Une base de données peut être reconstruite.
Mais un fichier contenant ses propres informations conserve une partie de son identité.
Les métadonnées deviennent ainsi une couche supplémentaire de sécurité organisationnelle.
Elles ne remplacent évidemment pas les sauvegardes.
Elles rendent simplement les fichiers beaucoup moins dépendants de leur environnement d’origine.
Un catalogue musical doit avoir une source de vérité
Lorsqu’un système utilise simultanément SQL, JSON, fichiers audio et caches, une règle devient particulièrement importante : il faut savoir quelle donnée est prioritaire.
Dans un système ancien, les fichiers JSON peuvent avoir été la source principale.
Après une migration, la base SQL peut devenir la référence.
Les JSON peuvent alors être reconstruits depuis cette base lorsque cela est nécessaire.
Cette évolution simplifie la maintenance.
Au lieu de corriger plusieurs fichiers indépendamment, on modifie une donnée centrale puis on régénère les éléments dérivés.
Les métadonnées servent aussi à l’utilisateur
Tout ce travail technique possède finalement un objectif très simple.
Lorsqu’un auditeur ouvre un morceau, il doit immédiatement comprendre ce qu’il écoute.
Le bon titre doit apparaître.
Le bon artiste.
Le bon album.
La bonne pochette.
Les pistes doivent être dans le bon ordre.
Lorsque tout fonctionne correctement, personne ne pense aux métadonnées.
C’est justement le signe qu’elles remplissent leur fonction.
Bien identifier aujourd’hui pour retrouver demain
Un catalogue musical grandit plus vite qu’on ne l’imagine.
Dix albums restent faciles à gérer mentalement.
Cent albums nécessitent déjà une véritable organisation.
Avec des centaines ou des milliers de morceaux, chaque information structurée devient précieuse.
Les tags ID3 ne sont donc pas un détail réservé aux techniciens.
Ils constituent une partie de l’archivage de l’œuvre.
Une musique correctement identifiée aujourd’hui sera beaucoup plus facile à classer, migrer, retrouver et écouter demain.
Pour aller plus loin
Pour approfondir la structure technique des métadonnées, la documentation officielle ID3.org constitue la référence historique du standard ID3 et décrit notamment les différentes versions et les informations pouvant être associées aux fichiers audio. Pour comprendre plus largement la manière dont les métadonnées sont exploitées dans un catalogue numérique, Apple Music for Artists propose des ressources officielles consacrées à la gestion et à la présentation des publications musicales. Enfin, la documentation de MusicBrainz Picard présente un outil libre spécialisé dans l’identification et l’organisation des fichiers musicaux à partir de métadonnées structurées.
Articles relatifs à la catégorie
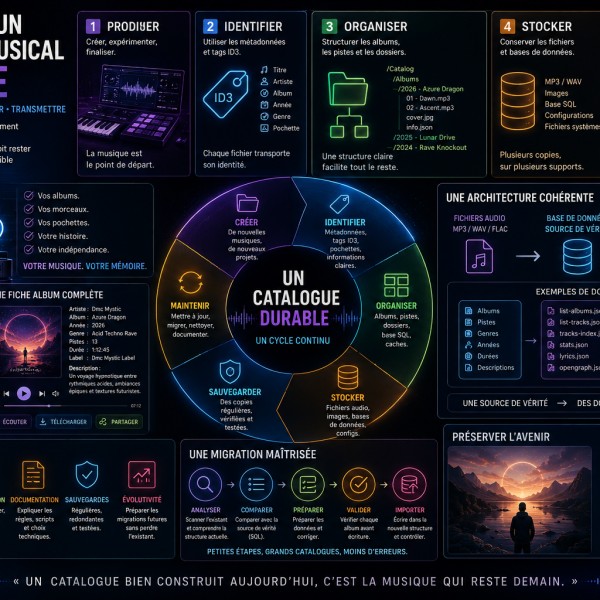
Produire de la musique est une chose. Conserver plusieurs années de créations dans un catalogue cohérent en est une autre. Lorsque les albums et les pistes s’accumulent, les noms de fichiers, les pochettes, les métadonnées, les bases de données et les sauvegardes deviennent aussi importants que l’espace de stockage lui-même. Un catalogue musical durable doit permettre de retrouver une œuvre, comprendre son organisation et reconstruire son environnement même plusieurs années après sa publication. Pour un artiste ou un label indépendant, cette organisation transforme progressivement une collection de fichiers audio en véritable patrimoine numérique.
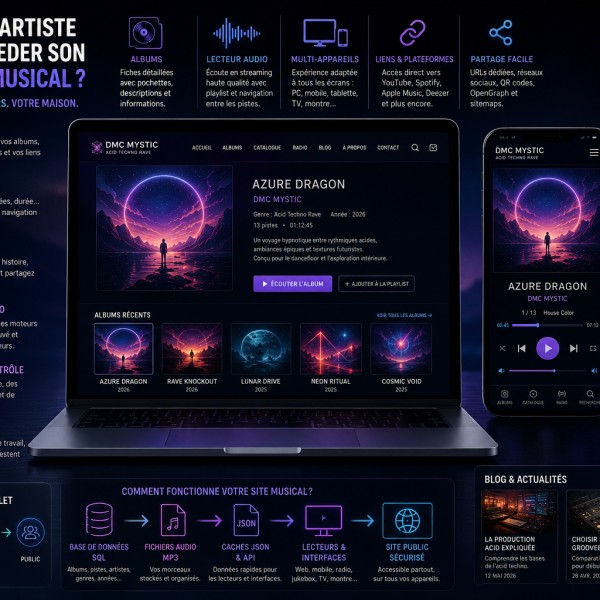
Spotify, YouTube, Apple Music et les autres plateformes permettent aujourd’hui de diffuser rapidement de la musique auprès d’un public immense. Pourtant, elles ne remplacent pas complètement un site appartenant directement à l’artiste ou au label. Un site musical indépendant permet d’organiser librement ses albums, ses morceaux, ses pochettes et ses informations sans dépendre entièrement de l’interface d’un service extérieur. Il devient à la fois catalogue, archive, espace éditorial et point central reliant les différents moyens d’écouter et de découvrir la musique.
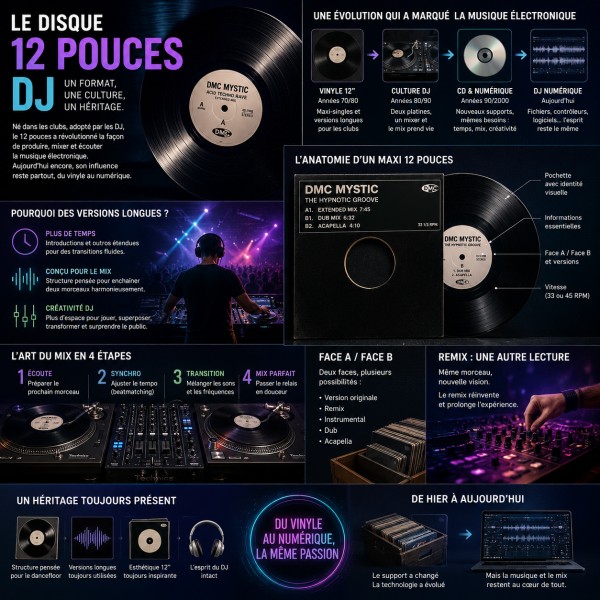
Avant les fichiers MP3, les contrôleurs et les plateformes numériques, une grande partie de la musique destinée aux DJ circulait sur vinyle. Parmi ces supports, le disque 12 pouces a occupé une place particulière grâce à sa qualité sonore, à ses versions longues et à sa conception adaptée au mixage. Aujourd’hui, un morceau peut être produit et diffusé entièrement sous forme numérique. Pourtant, l’héritage du 12 pouces reste profondément présent dans la House, la Techno et de nombreux autres styles électroniques. Structure des morceaux, versions extended, pochettes et culture DJ continuent d’en porter la trace.
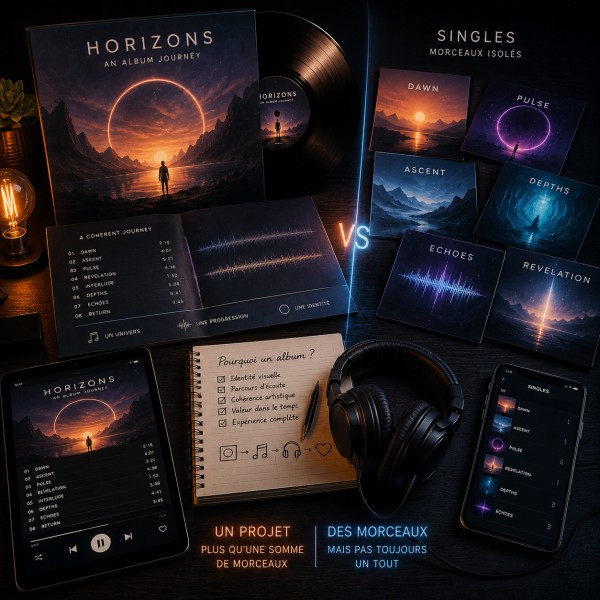
À l’époque de l’écoute immédiate et des playlists, publier les morceaux un par un peut sembler être la solution la plus naturelle. Pourtant, l’album conserve une force particulière : il permet de réunir plusieurs compositions autour d’une identité, d’une période ou d’une intention commune. Un album ne représente pas seulement plusieurs pistes placées dans le même dossier. Son titre, sa pochette, l’ordre des morceaux et son univers sonore peuvent transformer une série de productions indépendantes en une œuvre cohérente que l’auditeur découvre comme un ensemble.
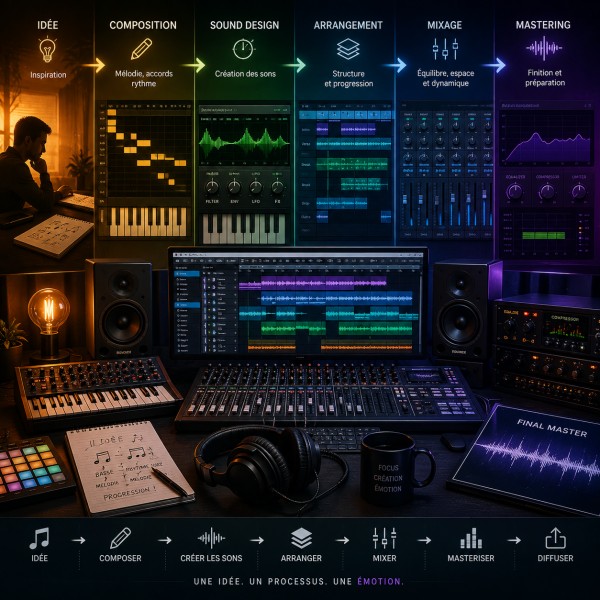
Entre la première idée musicale et le fichier audio prêt à être publié, un morceau traverse plusieurs étapes. Composition, arrangement, sound design, mixage puis mastering répondent chacun à un objectif différent. Comprendre ces étapes permet de mieux organiser son travail et surtout d’éviter une confusion fréquente : essayer de corriger au mastering un problème qui aurait dû être résolu pendant la composition ou le mixage. Suivons le parcours d’un morceau depuis ses premières notes jusqu’à sa version finale.
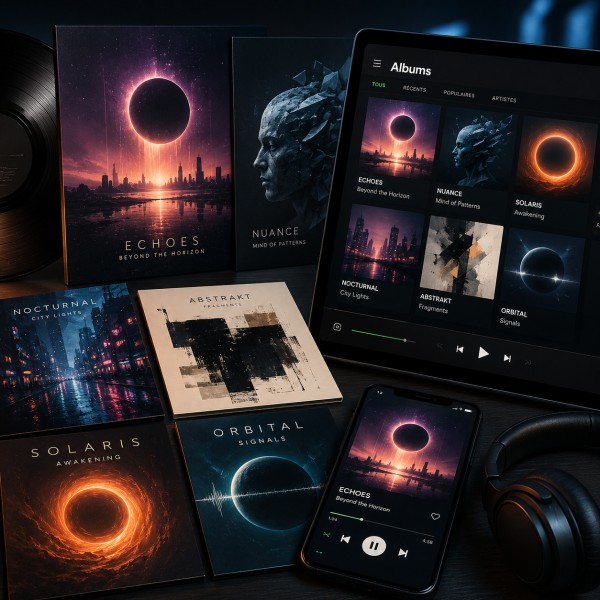
À l’époque du vinyle et du CD, la pochette occupait physiquement une place importante dans l’expérience musicale. Aujourd’hui, elle apparaît souvent sur l’écran d’un téléphone, dans un lecteur Web ou sous la forme d’une petite vignette. Pourtant, son rôle n’a pas disparu. La pochette permet d’identifier immédiatement un album, de lui donner une personnalité et d’associer une image durable à un univers sonore. Dans un catalogue numérique contenant des dizaines ou des centaines de publications, elle devient même un véritable outil de navigation.
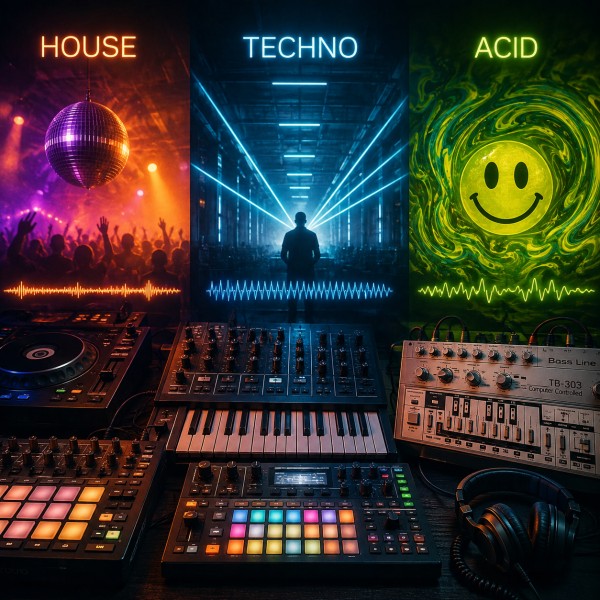
Techno, House et Acid utilisent souvent des instruments similaires : boîtes à rythmes, synthétiseurs, séquenceurs et lignes de basse électroniques. Pourtant, quelques secondes d’écoute peuvent suffire à révéler des univers très différents. Le rythme, le traitement de la basse, la place de la mélodie et surtout la manière dont les sons évoluent permettent progressivement de reconnaître chaque style. Voici quelques repères simples pour mieux comprendre leurs différences sans transformer l’écoute musicale en cours de théorie.
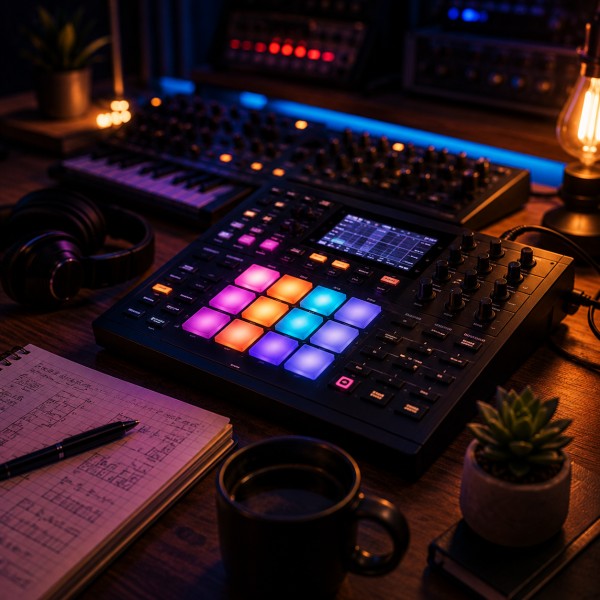
Créer de la musique électronique ne nécessite plus forcément un studio rempli de machines, une immense console de mixage ou plusieurs ordinateurs. Les grooveboxes, contrôleurs et environnements de production compacts permettent aujourd’hui de composer des morceaux complets à partir d’un espace de travail extrêmement réduit. Rythmes, basses, mélodies, effets et arrangements peuvent être construits progressivement autour d’une même idée. Cette manière de produire privilégie la spontanéité et transforme la machine en véritable instrument de création.
Un album de musique électronique ne naît pas simplement d’une accumulation de morceaux. Derrière chaque projet se construisent progressivement une identité sonore, une ambiance et une cohérence capables de relier plusieurs pistes dans un même univers. De la première mélodie au classement final des morceaux, en passant par l’arrangement, le mixage, le mastering et la création de la pochette, découvrons comment une série d’idées musicales peut devenir un véritable album prêt à être publié et écouté.