Quelques morceaux sont faciles à organiser
Lorsque l’on commence à produire de la musique, l’organisation paraît rarement compliquée.
Quelques morceaux tiennent dans un répertoire.
Les titres sont encore faciles à mémoriser.
Les pochettes sont immédiatement reconnaissables.
On sait exactement où se trouve chaque projet.
Puis le catalogue grandit.
Dix morceaux deviennent cinquante.
Quelques albums deviennent plusieurs dizaines.
Les années passent et de nouvelles méthodes de production apparaissent.
À ce moment, la mémoire de l’artiste ne suffit plus.
Il faut construire une véritable organisation.
Un catalogue est davantage qu’un répertoire de MP3
Un répertoire contenant des fichiers audio constitue une collection.
Un catalogue ajoute une structure autour de ces fichiers.
Chaque album possède un titre.
Une année.
Un genre.
Une pochette.
Une description.
Une liste de pistes.
Chaque piste possède elle aussi son titre, sa position, sa durée et différentes informations permettant de l’identifier.
Cette structure transforme les fichiers en œuvres documentées.
L’album constitue une excellente unité d’organisation
Pour un catalogue composé de nombreuses productions, l’album fournit naturellement un premier niveau de classement.
Un répertoire peut représenter un projet.
Les fichiers audio se trouvent à l’intérieur.
Les images sont regroupées dans un emplacement identifiable.
Les informations nécessaires au site ou au lecteur peuvent être conservées dans des espaces dédiés.
Cette organisation possède un avantage considérable : chaque album devient presque autonome.
Lorsqu’il faut travailler sur un projet particulier, toutes les ressources nécessaires sont faciles à identifier.
Les noms de fichiers doivent rester prévisibles
Une bonne organisation repose en partie sur des conventions.
Si chaque album utilise des noms de fichiers totalement différents, l’automatisation devient difficile.
À l’inverse, une structure prévisible permet à un programme de comprendre rapidement ce qu’il rencontre.
Par exemple, les pistes peuvent être numérotées.
Les images principales peuvent utiliser des noms standardisés.
Les fichiers de configuration peuvent toujours se trouver au même endroit.
Cette régularité n’empêche pas la créativité musicale.
Elle simplifie simplement la gestion technique.
Les métadonnées donnent une identité aux fichiers
Comme nous l’avons vu avec les tags ID3, un fichier audio correctement identifié transporte une partie de son contexte.
Le titre indique ce que l’on écoute.
L’artiste indique son origine.
L’album conserve son appartenance.
L’année situe le projet.
Le genre facilite son classement.
La pochette maintient son identité visuelle.
Ces informations sont particulièrement précieuses lorsqu’un fichier quitte son emplacement d’origine.
Même copié ailleurs, il reste identifiable.
La base de données devient la mémoire structurée du site
Lorsqu’un catalogue Web grandit, une base SQL peut devenir le centre de son organisation.
Au lieu de rechercher les informations dans de nombreux fichiers indépendants, le site peut interroger une structure commune.
Quel est le dernier album publié ?
Quels albums appartiennent à une année donnée ?
Quel est le genre d’un projet ?
Combien possède-t-il de pistes ?
Quelle est sa description ?
Quel slug doit être utilisé pour construire son URL ?
La base permet de répondre rapidement à ces questions.
Déterminer une source de vérité
Un catalogue ancien peut avoir connu plusieurs générations techniques.
Certaines informations peuvent se trouver dans des fichiers texte.
D’autres dans des JSON.
D’autres encore dans les tags des MP3.
Puis une base SQL est ajoutée.
Le risque est alors de conserver plusieurs versions contradictoires d’une même information.
Il faut donc choisir une source principale.
Après une migration vers SQL, la base peut par exemple devenir la référence du catalogue public.
Les caches et autres fichiers techniques peuvent ensuite être régénérés à partir des informations validées.
Cette décision simplifie énormément la maintenance future.
Un cache n’est pas nécessairement une archive
Les caches sont très utiles.
Ils permettent d’éviter certaines opérations répétitives et peuvent fournir rapidement des données aux lecteurs, interfaces ou API.
Mais un cache devrait idéalement pouvoir être reconstruit.
Il ne faut donc pas automatiquement considérer chaque fichier de cache comme l’unique endroit où conserver une information importante.
La donnée essentielle doit exister dans une source durable.
Le cache sert ensuite à l’exploitation.
Cette distinction devient particulièrement importante lors d’une migration.
Préserver les fichiers originaux
Lorsqu’une infrastructure évolue, la tentation peut être grande de remplacer immédiatement tous les anciens fichiers.
Il est souvent préférable de conserver les sources originales pendant la migration.
Les anciens JSON peuvent contenir une information oubliée.
Un fichier texte peut expliquer une ancienne convention.
Un ancien index peut permettre de comprendre comment fonctionnait un lecteur.
Ces éléments n’ont pas nécessairement vocation à rester utilisés par le site public.
Ils peuvent cependant être extrêmement précieux comme archives techniques.
Une migration doit pouvoir être contrôlée
Migrer un catalogue important en une seule opération peut sembler rapide.
Mais une erreur répétée sur cent albums devient immédiatement un problème considérable.
Une méthode plus sûre consiste à travailler par étapes.
Identifier l’album.
Scanner ses pistes.
Lire ses informations existantes.
Comparer les données.
Préparer les modifications.
Valider.
Écrire dans la nouvelle structure.
Contrôler le résultat.
Puis seulement passer au projet suivant.
Cette approche est plus lente au début mais beaucoup plus facile à diagnostiquer lorsqu’un cas particulier apparaît.
Automatiser sans supprimer le contrôle humain
L’automatisation devient indispensable lorsqu’un catalogue contient beaucoup de contenus.
Un outil peut scanner automatiquement les MP3.
Il peut calculer leur durée.
Compter les pistes.
Lire des JSON.
Comparer un titre avec la base SQL.
Préparer une migration.
Mais toutes les décisions ne doivent pas nécessairement être aveugles.
Lorsqu’une valeur est ambiguë, une validation humaine peut rester préférable.
Le meilleur système n’est donc pas forcément celui qui ne demande jamais aucune intervention.
C’est celui qui automatise les opérations répétitives tout en signalant clairement les exceptions.
Les rapports permettent de savoir ce qui s’est réellement passé
Une automatisation devient beaucoup plus utile lorsqu’elle laisse une trace.
Quel album a été traité ?
Combien de fichiers ont été détectés ?
Combien de pistes ont été ajoutées ?
Des avertissements ont-ils été rencontrés ?
Une erreur s’est-elle produite ?
Combien de temps l’opération a-t-elle demandé ?
Ces rapports permettent de vérifier l’état général d’une migration sans devoir ouvrir chaque album manuellement.
Ils deviennent aussi une mémoire technique.
Les sauvegardes ne sont pas facultatives
Un catalogue musical représente parfois des années de travail.
Les fichiers audio peuvent être recréés dans certains cas, mais parfois ils constituent les seuls masters encore disponibles.
Les pochettes peuvent avoir nécessité plusieurs heures de travail.
La base de données contient l’organisation de tout le catalogue.
Perdre l’un de ces éléments peut être extrêmement coûteux.
Une sauvegarde sérieuse ne doit donc pas se limiter à une copie occasionnelle du site.
Elle doit prendre en compte les fichiers musicaux, les images, la base de données, les configurations et les éléments nécessaires à une restauration.
Une sauvegarde doit être restaurable
Posséder un fichier de sauvegarde ne garantit pas qu’il soit utilisable.
Une archive peut être incomplète.
Un export SQL peut rencontrer un problème.
Certains fichiers peuvent manquer.
Les permissions peuvent empêcher la restauration.
Il est donc important de vérifier périodiquement que les sauvegardes permettent réellement de reconstruire le système.
La question n’est pas seulement :
« Ai-je une sauvegarde ? »
Mais :
« Est-ce que je pourrais repartir de cette sauvegarde si le serveur disparaissait demain ? »
Conserver plusieurs générations peut sauver un catalogue
Écraser systématiquement la sauvegarde précédente est risqué.
Un problème peut rester invisible pendant plusieurs jours.
Si chaque nouvelle sauvegarde remplace immédiatement l’ancienne, l’erreur peut finir par être copiée partout.
Conserver plusieurs générations permet de revenir à un état antérieur.
Une sauvegarde récente répond à un accident immédiat.
Une sauvegarde plus ancienne peut répondre à un problème découvert tardivement.
Les deux sont utiles.
Les URLs font également partie du patrimoine
Lorsqu’un site évolue, il ne faut pas oublier ses adresses.
Une ancienne fiche album peut avoir été partagée ailleurs.
Un moteur de recherche peut l’avoir indexée.
Un utilisateur peut l’avoir enregistrée dans ses favoris.
Changer toute la structure sans prévoir de redirections peut casser ces références.
Préserver les URLs importantes ou mettre en place des redirections adaptées permet de faire évoluer l’infrastructure sans effacer son histoire publique.
Les images doivent elles aussi être organisées
Un album peut aujourd’hui utiliser plusieurs variantes de son identité visuelle.
Une pochette carrée.
Une vignette.
Une image destinée aux aperçus sociaux.
Un arrière-plan.
Des déclinaisons adaptées à certaines interfaces.
Lorsque ces fichiers utilisent des noms et dimensions prévisibles, ils deviennent beaucoup plus faciles à gérer automatiquement.
Le système peut savoir quelle image utiliser sans devoir effectuer un choix manuel à chaque affichage.
Documenter les règles importantes
Une architecture peut sembler parfaitement évidente à la personne qui vient de la construire.
Six mois plus tard, certains choix peuvent déjà être difficiles à comprendre.
Pourquoi ce répertoire porte-t-il ce nom ?
Quel JSON est encore utilisé ?
Quelle table SQL constitue la référence ?
Quel script reconstruit le cache ?
Quelles informations ne doivent jamais être écrasées ?
Une documentation même courte peut éviter énormément de recherches.
Elle permet également de distinguer les règles permanentes des solutions temporaires.
Penser au prochain changement avant qu’il arrive
Aucune infrastructure ne reste éternellement identique.
Le serveur changera peut-être.
Une nouvelle version de PHP arrivera.
Le lecteur audio sera remplacé.
Un nouveau format d’image deviendra intéressant.
Le catalogue dépassera peut-être plusieurs centaines d’albums.
Une architecture durable ne cherche pas à prédire exactement toutes ces évolutions.
Elle essaie surtout de ne pas les rendre impossibles.
Des données propres, des conventions stables et des sauvegardes complètes offrent cette liberté.
Le catalogue devient un patrimoine numérique
À partir d’un certain volume, le catalogue ne représente plus seulement les morceaux actuellement mis en avant.
Il contient une histoire.
Les premières productions.
Les changements de styles.
Les expériences.
Les pochettes.
Les différentes périodes techniques.
Les albums récents.
Tout cela constitue progressivement une archive de création.
La valeur du système ne réside donc pas uniquement dans sa capacité à diffuser la musique aujourd’hui.
Elle réside aussi dans sa capacité à préserver cette musique pour demain.
Produire, identifier, organiser, sauvegarder
Construire un catalogue musical durable peut finalement être résumé par quatre principes.
Produire, parce que la musique reste évidemment le point de départ.
Identifier, afin que chaque album et chaque piste possède des informations fiables.
Organiser, pour que le catalogue puisse grandir sans devenir impossible à maintenir.
Sauvegarder, afin que plusieurs années de travail ne dépendent jamais d’un seul serveur ou d’un seul support.
Un catalogue bien construit devient alors beaucoup plus qu’une collection de MP3.
Il devient une mémoire musicale structurée, capable d’évoluer avec les technologies sans perdre l’histoire qu’elle contient.
Pour aller plus loin
Pour approfondir les bonnes pratiques de conservation numérique, la Library of Congress — Digital Preservation rassemble des ressources institutionnelles consacrées à la préservation des contenus numériques. Pour la stratégie de sauvegarde, CISA publie également des recommandations officielles de cybersécurité incluant la protection et la récupération des données. Enfin, pour les métadonnées musicales elles-mêmes, ID3.org documente le standard ID3 utilisé pour transporter les informations associées aux fichiers MP3. Ces références montrent qu’un catalogue durable repose autant sur la qualité de son organisation que sur la conservation des fichiers eux-mêmes.
Articles relatifs à la catégorie
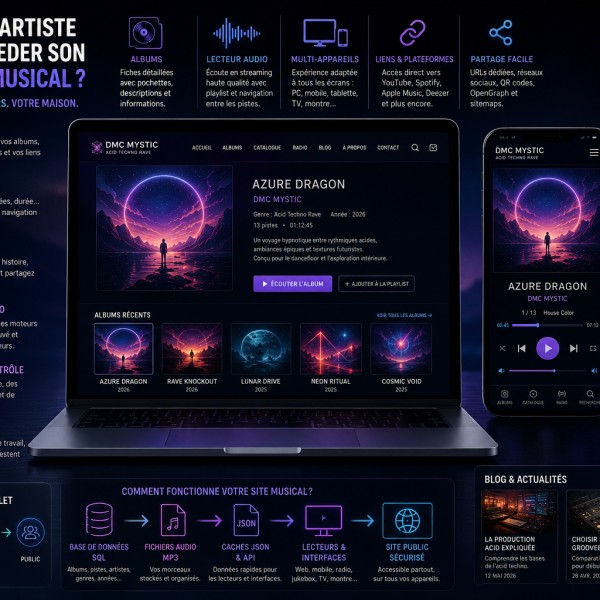
Spotify, YouTube, Apple Music et les autres plateformes permettent aujourd’hui de diffuser rapidement de la musique auprès d’un public immense. Pourtant, elles ne remplacent pas complètement un site appartenant directement à l’artiste ou au label. Un site musical indépendant permet d’organiser librement ses albums, ses morceaux, ses pochettes et ses informations sans dépendre entièrement de l’interface d’un service extérieur. Il devient à la fois catalogue, archive, espace éditorial et point central reliant les différents moyens d’écouter et de découvrir la musique.
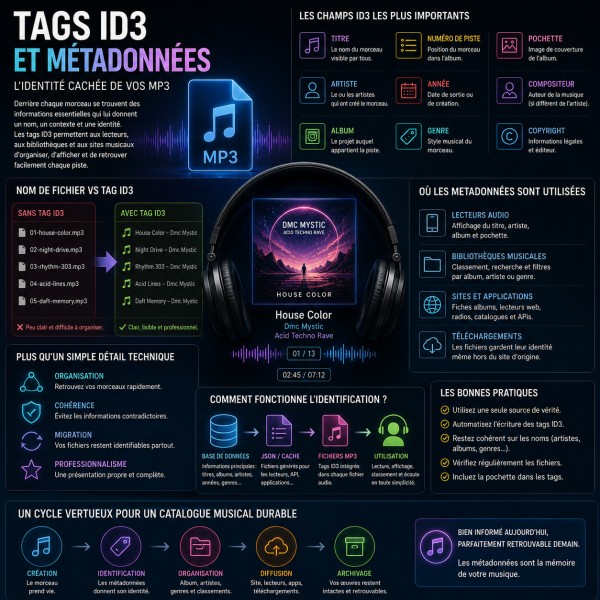
Un fichier MP3 peut parfaitement contenir de la musique sans aucune information supplémentaire. Mais dès qu’une bibliothèque rassemble plusieurs albums et des centaines de morceaux, le simple nom du fichier ne suffit plus. Titre, artiste, album, année, genre, numéro de piste et pochette constituent les métadonnées qui permettent aux lecteurs et aux bibliothèques musicales de comprendre ce qu’ils diffusent. Les tags ID3 jouent ainsi un rôle discret mais essentiel : ils donnent une identité structurée au fichier audio et permettent à la musique de rester correctement organisée lorsqu’elle quitte son répertoire d’origine.
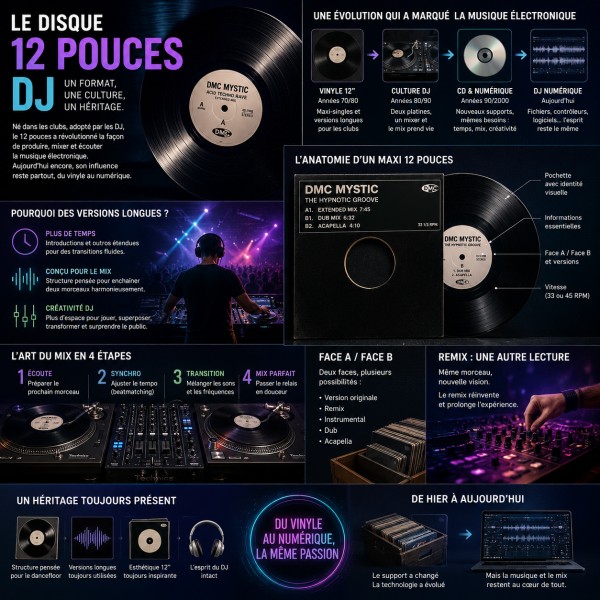
Avant les fichiers MP3, les contrôleurs et les plateformes numériques, une grande partie de la musique destinée aux DJ circulait sur vinyle. Parmi ces supports, le disque 12 pouces a occupé une place particulière grâce à sa qualité sonore, à ses versions longues et à sa conception adaptée au mixage. Aujourd’hui, un morceau peut être produit et diffusé entièrement sous forme numérique. Pourtant, l’héritage du 12 pouces reste profondément présent dans la House, la Techno et de nombreux autres styles électroniques. Structure des morceaux, versions extended, pochettes et culture DJ continuent d’en porter la trace.
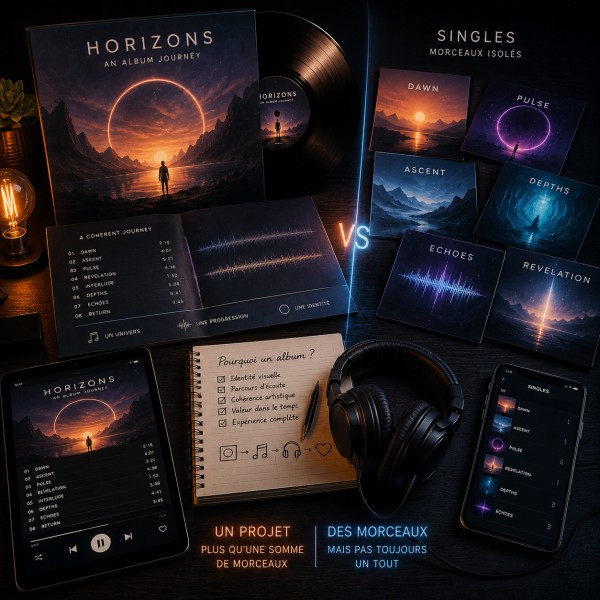
À l’époque de l’écoute immédiate et des playlists, publier les morceaux un par un peut sembler être la solution la plus naturelle. Pourtant, l’album conserve une force particulière : il permet de réunir plusieurs compositions autour d’une identité, d’une période ou d’une intention commune. Un album ne représente pas seulement plusieurs pistes placées dans le même dossier. Son titre, sa pochette, l’ordre des morceaux et son univers sonore peuvent transformer une série de productions indépendantes en une œuvre cohérente que l’auditeur découvre comme un ensemble.
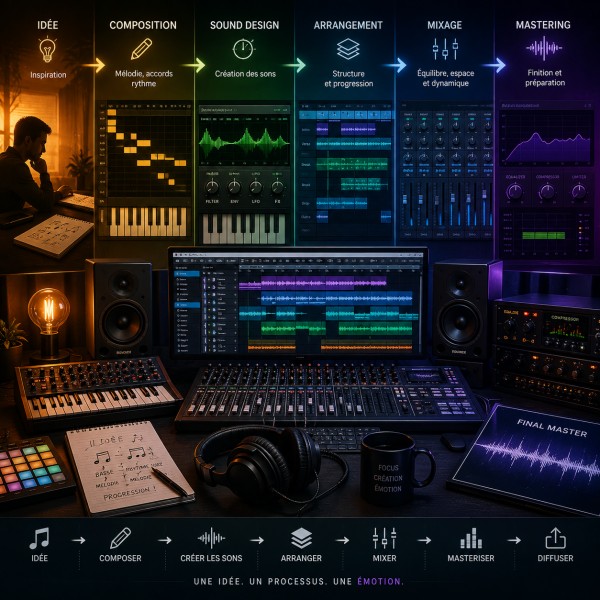
Entre la première idée musicale et le fichier audio prêt à être publié, un morceau traverse plusieurs étapes. Composition, arrangement, sound design, mixage puis mastering répondent chacun à un objectif différent. Comprendre ces étapes permet de mieux organiser son travail et surtout d’éviter une confusion fréquente : essayer de corriger au mastering un problème qui aurait dû être résolu pendant la composition ou le mixage. Suivons le parcours d’un morceau depuis ses premières notes jusqu’à sa version finale.
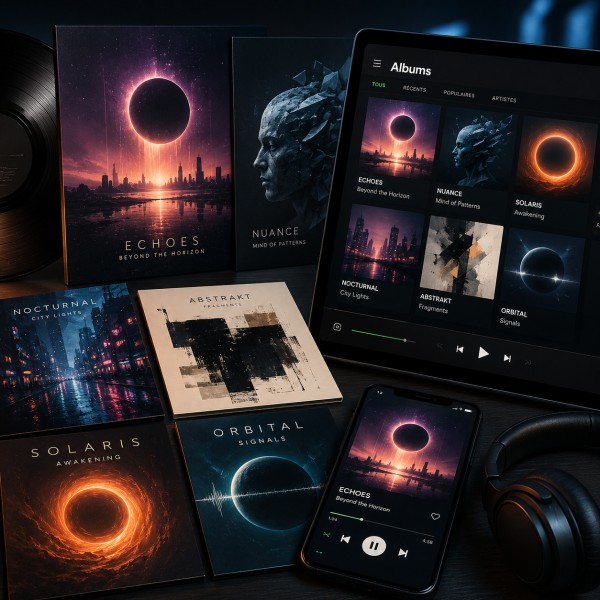
À l’époque du vinyle et du CD, la pochette occupait physiquement une place importante dans l’expérience musicale. Aujourd’hui, elle apparaît souvent sur l’écran d’un téléphone, dans un lecteur Web ou sous la forme d’une petite vignette. Pourtant, son rôle n’a pas disparu. La pochette permet d’identifier immédiatement un album, de lui donner une personnalité et d’associer une image durable à un univers sonore. Dans un catalogue numérique contenant des dizaines ou des centaines de publications, elle devient même un véritable outil de navigation.
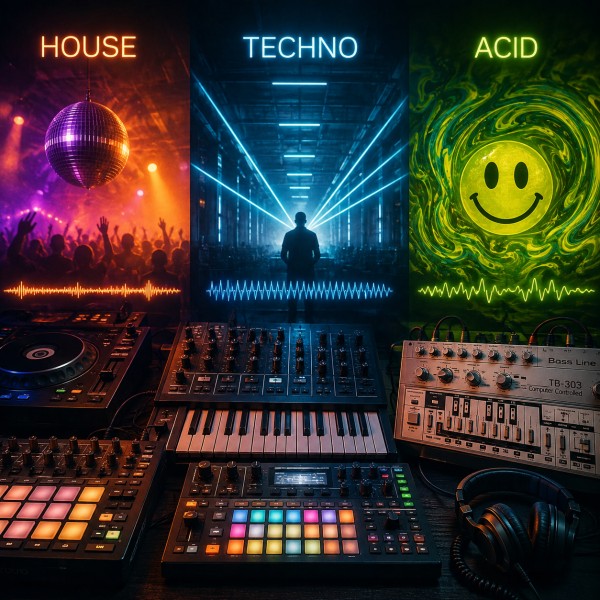
Techno, House et Acid utilisent souvent des instruments similaires : boîtes à rythmes, synthétiseurs, séquenceurs et lignes de basse électroniques. Pourtant, quelques secondes d’écoute peuvent suffire à révéler des univers très différents. Le rythme, le traitement de la basse, la place de la mélodie et surtout la manière dont les sons évoluent permettent progressivement de reconnaître chaque style. Voici quelques repères simples pour mieux comprendre leurs différences sans transformer l’écoute musicale en cours de théorie.
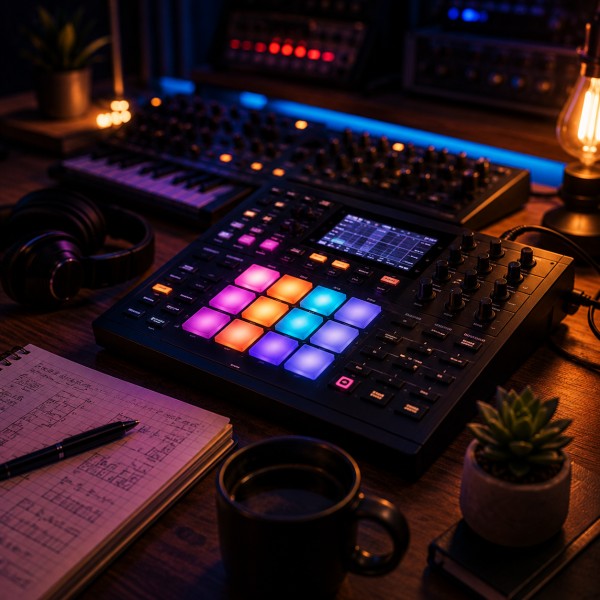
Créer de la musique électronique ne nécessite plus forcément un studio rempli de machines, une immense console de mixage ou plusieurs ordinateurs. Les grooveboxes, contrôleurs et environnements de production compacts permettent aujourd’hui de composer des morceaux complets à partir d’un espace de travail extrêmement réduit. Rythmes, basses, mélodies, effets et arrangements peuvent être construits progressivement autour d’une même idée. Cette manière de produire privilégie la spontanéité et transforme la machine en véritable instrument de création.
Un album de musique électronique ne naît pas simplement d’une accumulation de morceaux. Derrière chaque projet se construisent progressivement une identité sonore, une ambiance et une cohérence capables de relier plusieurs pistes dans un même univers. De la première mélodie au classement final des morceaux, en passant par l’arrangement, le mixage, le mastering et la création de la pochette, découvrons comment une série d’idées musicales peut devenir un véritable album prêt à être publié et écouté.